
"100개 중 30개만 생존"…LG전자, 로봇 학습 위한 '데이터 팩토리' 가동
LG전자가 로봇 학습을 위한 전용 공간 '데이터 팩토리'를 통해 피지컬 AI 시장 공략에 나선다. 데이터 생성부터 검증까지 아우르는 체계를 구축해 로봇 학습의 비용과 시간 문제를 해결한다는 전략이다.
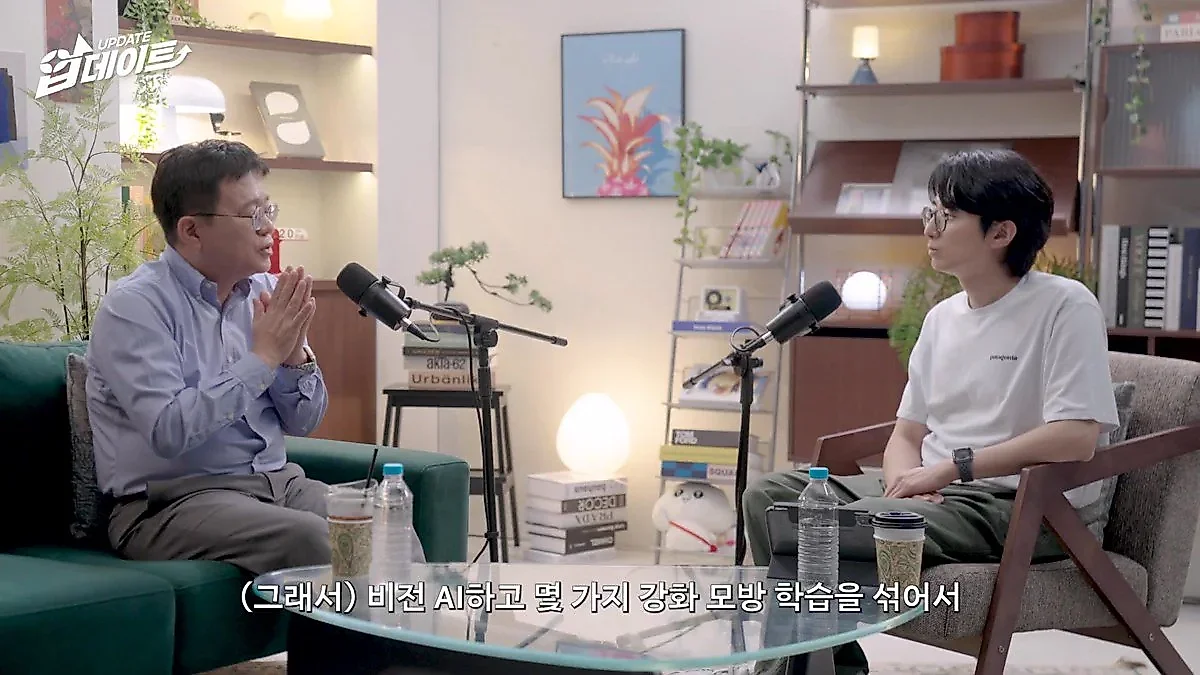
로봇이 사람처럼 움직이기 위해서는 방대한 양의 학습 데이터가 필수적이다. 하지만 로봇이 현장에서 마주하는 데이터는 정제되지 않은 원석과 같아, 이를 실제 학습에 사용할 수 있는 '정답지'로 만드는 과정에는 막대한 비용과 시간이 소요된다. LG전자는 이 문제를 해결하기 위해 데이터를 생성하고, 정제하고, 학습시킨 뒤 검증까지 수행하는 일종의 로봇 훈련소인 'LG데이터팩토리'를 구축했다.
"100개 중 30개만 쓸 수 있다"…로봇 데이터의 높은 문턱
LG전자가 운영하는 데이터 팩토리는 로봇을 위한 '학원'과 같다. LG전자 박기범 담당은 데이터 팩토리를 "데이터를 생성·정제·학습·검증하는 로봇 훈련소이자 학습지를 만드는 곳"이라고 정의했다. 현재 이곳에는 약 100대의 로봇이 배치되어 있으며, 연말까지 200대 규모로 확충될 예정이다. 박 담당은 "하반기에 시작했는데 200대가 금방 나올 정도로 속도가 빠르다"며 "실제 양산 규모는 이보다 훨씬 더 많다"고 밝혔다.
로봇 학습의 가장 큰 난제는 데이터의 질이다. 박 담당에 따르면, 사람이 직접 로봇을 조종해 데이터를 수집하는 '텔레오퍼레이션(Teleoperation)' 방식은 가장 양질의 데이터를 얻을 수 있지만, 숙련된 작업자의 노동력이 투입되어야 하기에 시간과 비용이 매우 높다. 실제로 텔레오퍼레이션을 통해 100개의 데이터를 수집하더라도, 조작자에 따라 차이가 있지만 실제 학습에 활용할 수 있는 유효 데이터는 약 30% 수준에 불과하다.
LG전자는 이 한계를 극복하기 위해 세 가지 경로로 데이터를 확보한다. 첫째는 직접 로봇을 조종해 얻는 데이터, 둘째는 사람의 움직임을 로봇의 움직임으로 변환하는 '리타게팅(Retargeting)' 기술을 활용한 데이터, 셋째는 가상 환경에서 데이터를 증폭시키는 '합성 데이터(Synthetic Data)' 방식이다. 리타게팅은 사람의 휴먼 비디오와 로봇의 액츄에이터(Actuator) 값을 매핑하는 작업이다. 특히 최근에는 비전 AI와 모방 학습을 결합해 로봇이 스스로 움직이며 정답지를 만들어내는 '오토옵스(Auto-ops)' 기술을 통해 사람의 개입을 줄이고 데이터 생성 속도를 높이는 데 집중하고 있다. 다만 박 담당은 "오토옵스는 속도가 빠르고 사람 없이 데이터를 축적할 수 있지만, 데이터의 다양성이 부족하다는 단점이 있다"고 덧붙였다.
데이터 플라이휠과 '오토옵스'…현장 격차 줄이는 기술력
로봇이 학습한 내용을 실제 현장에 적용할 때 발생하는 '도메인 갭(Domain Gap)'을 해결하는 것도 데이터 팩토리의 핵심 과제다. 공장의 조명이 다르거나 선반의 높이와 개수가 미세하게 차이 나는 등 예상치 못한 변수가 발생하면 로봇은 오작동할 수 있다. 이를 위해 LG전자는 데이터를 생성하고, 학습시키고, 현장에 내보낸 뒤 다시 데이터를 수집해 재학습하는 '데이터 플라이휠(Data Flywheel)' 구조를 운영한다.
박 담당은 이 과정을 수능 시험에 비유했다. "트레이닝과 미드 트레이닝 과정이 여러 번의 모의고사라면, 현장 실증(PoC)은 수능 시험과 같다"며, "모의고사를 통해 다양한 변수를 학습하고, 마지막 단계에서 실제 현장에 맞춘 포스트 트레이닝을 거쳐 완성도를 높인다"고 설명했다. 학습에 필요한 데이터 양은 작업 종류에 따라 차이가 큰데, 예를 들어 컵을 옮기는 등의 태스크는 포스트 트레이닝 기준으로 약 100시간 내외의 데이터로도 효과를 보기도 한다.
LG전자는 외부에서 데이터를 구매하는 대신 자체 기체를 활용한 데이터 구축 전략을 고수한다. 외부 데이터는 가격이 저렴할 수 있지만, LG전자가 직접 만든 로봇 기체의 특성(Form Factor)과 일치하지 않으면 정확도가 떨어진다는 이유에서다. 로봇 학습은 '어떤 업무를 할 것인가'와 '그때 나의 몸(기체)은 어떤 상태여야 하는가'라는 두 가지 세트가 핵심인데, 자사 기체로 만든 데이터가 훨씬 정확도가 높기 때문이다. 박 담당은 "우리 기체에 특화된 모델을 만들면 고객이 현장에서 특정 업무를 수행할 때 훨씬 적은 양의 데이터와 시간만으로도 정교한 학습이 가능하다"고 강조했다.
'One LG' 시너지로 피지컬 AI 주도권 확보
데이터 팩토리는 LG그룹의 역량이 집결된 공간이다. AI 연구원의 독자 모델 개발 및 미드 트레이닝 전문가 역할, LG이노텍의 고성능 카메라 기술(비디오 시그널 처리), LG CNS의 고객 맞춤형 시스템 구축 및 딜리버리 역량이 한데 모였다. 이러한 'One LG' 체제는 하드웨어와 소프트웨어를 통합해 완성형 로봇을 빠르게 공급할 수 있는 기반이 된다.
최근 엔비디아(NVIDIA) 관계자들은 데이터 팩토리를 방문해 "인크레더블(Incredible)"이라는 표현을 쓸 정도로 LG의 준비 속도에 놀라움을 표하기도 했다. 박 담당은 "미국 기업들이 로봇 테스트를 위해 에어비앤비를 빌려 공간을 확보하는 것과 달리, LG는 대규모 데이터를 다룰 수 있는 인프라와 양산 단계의 문제를 해결할 수 있는 환경을 동시에 구축했다"고 설명했다. 그는 또한 LG를 엔비디아에게는 E2E(End-to-End)로 어셈블해 제공할 수 있는 파트너로, MS에게는 로봇 운영을 위한 클라우드 인프라를 제공할 수 있는 협력 모델로 바라보고 있다.
결국 피지컬 AI(Physical AI) 시대의 승부처는 '누가 더 양질의 데이터를 효율적으로 확보하느냐'에 달려 있다. LG전자는 데이터 팩토리를 통해 구축한 기술력을 바탕으로, 가사 노동을 대신하는 '제로 레이버 홈(Zero Labor Home)' 비전을 실현해 나갈 계획이다.
출처: LG그룹 유튜브 「로봇 데이터 100개 중 30개만 살아남는다? 로봇 학습이 어렵고 비싼 이유 | LG전자 박기범 담당 | 업데이트 EP.8」
0댓글
현재 댓글 작성이 비활성화되어 있습니다.