
"100개 중 30개만 생존"…LG전자, 로봇 학습 데이터 직접 만드는 '데이터팩토리' 가동
LG전자가 로봇 학습 데이터의 생성부터 검증까지 수행하는 'LG데이터팩토리'를 통해 피지컬 AI 경쟁력을 강화한다. 수집 데이터의 30%만이 활용되는 높은 학습 문턱을 넘기 위해 자사 기체 특화 데이터와 오토옵스 기술을 활용한다.
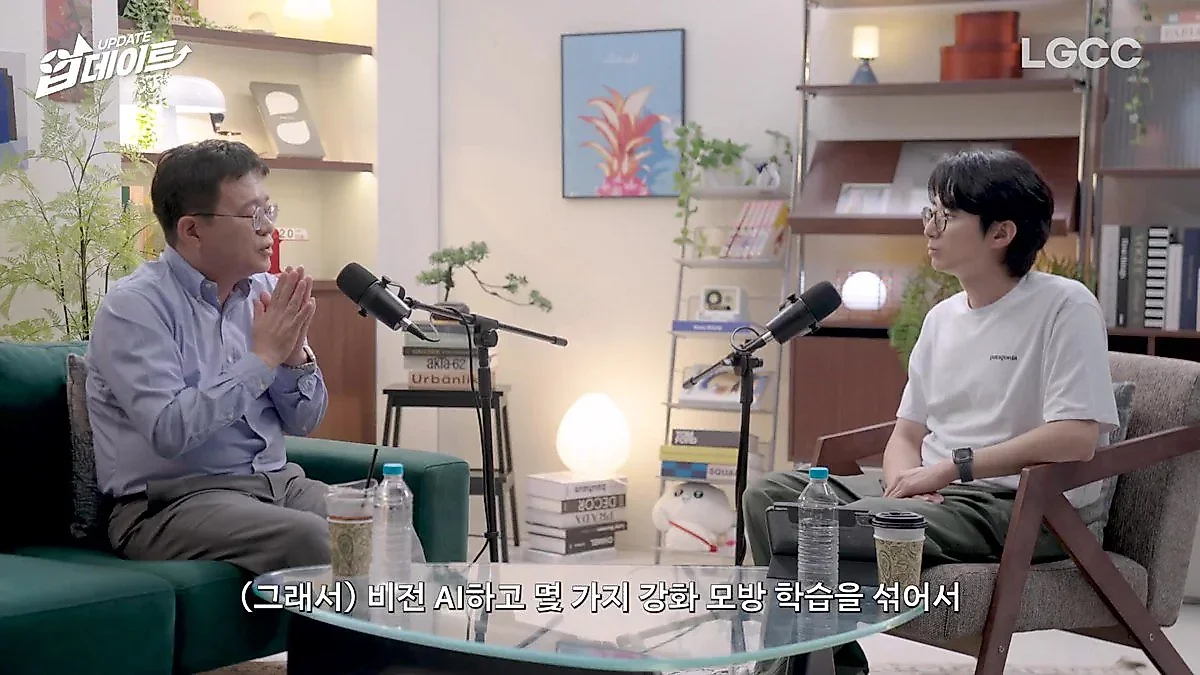
로봇이 사람처럼 움직이기 위해서는 방대한 양의 학습 데이터가 필수적이다. LG전자는 로봇이 데이터를 생성하고, 정제하고, 학습한 뒤 검증까지 마칠 수 있도록 돕는 일종의 '로봇 훈련소'인 'LG데이터팩토리'를 운영하며 로봇 상용화를 준비하고 있다.
"100개 중 30개만 쓸 수 있는 데이터"…로봇 학습의 높은 문턱
LG전자 박기범 담당에 따르면, 로봇 학습을 위해 사람이 직접 조종하며 데이터를 수집하는 '텔레오퍼레이션(Teleoperation)' 방식은 높은 비용과 시간이 소요되는 작업이다. 숙련된 작업자가 로봇을 조종해 정답지를 만드는 과정이 필요하기 때문이다. 특히 이렇게 수집된 데이터 중 실제 학습에 활용할 수 있는 양은 조작자에 따라 차이가 있으나 약 30% 수준에 불과하다.
부족한 데이터를 보충하기 위해 가상 환경을 활용한 시뮬레이션 데이터 생성이나, 사람의 움직임을 로봇의 움직임으로 변환하는 리타게팅(Retargeting) 기술, 데이터를 인위적으로 늘리는 증강 기술 등이 활용된다. LG전자는 비전 AI와 모방 학습을 결합해 로봇이 스스로 정답지를 만들어내는 '오토옵스(Auto-Ops)' 기술을 통해 사람의 개입을 줄이고 데이터 생성 속도를 높이는 전략을 추진하고 있다.
연말까지 로봇 200대 세트업…'데이터 플라이휠' 구축
LG데이터팩토리는 데이터의 생성, 정제, 학습, 검증이 연속적으로 이어지는 '데이터 플라이휠(Data Flywheel)' 구조를 지향한다. 현장에 투입된 로봇이 예상치 못한 환경(도메인 갭)을 마주하면, 다시 데이터를 수집해 학습을 반복하는 순환 구조다. 이를 위해 LG전자는 현재 약 100대의 로봇을 운용 중이며, 올해 연말까지는 200대 규모로 인프라를 확대할 계획이다.
데이터팩토리는 단순한 연구실을 넘어 대규모 데이터를 처리할 수 있는 IT 인프라와 네트워크 환경을 갖추고 있다. 비디오 데이터의 막대한 대역폭을 처리하기 위해 네 종류의 와이파이를 혼용하며, 대량의 GPU 자원을 공동으로 소비하는 인프라를 구축했다. 박 담당은 이를 통해 시뮬레이션 단계(모의고사)를 거쳐 실제 현장 실증(수능)으로 이어지는 단계별 학습 체계를 갖추고 있다고 설명했다.
"우리 기체에 특화된 모델이 더 정확"…One LG 시너지로 빅테크와 협업
LG전자의 로봇 전략은 자사 기체(Form-factor)에 최적화된 데이터를 직접 생산해 모델의 정확도를 높이는 데 방점을 둔다. 외부에서 구매한 데이터보다 자사 로봇의 특성을 반영한 데이터가 학습 효율과 정확도 면에서 우위에 있기 때문이다. 이는 고객이 로봇을 도입했을 때 적은 양의 데이터와 시간만으로도 특정 업무를 수행할 수 있게 만드는 기반이 된다.
이러한 전략을 위해 데이터팩토리에는 LG전자뿐만 아니라 AI 연구원, LG CNS, LG 이노텍 등 그룹 내 역량이 결집된 'One LG' 팀이 모여 있다. 카메라 인터페이스를 담당하는 이노텍, 상업·물류 공간에 로봇을 인도하고 고객 요구에 맞게 학습을 지원하는 CNS, 독자 모델 개발을 지원하는 AI 연구원이 협업한다. 이를 바탕으로 LG전자는 엔비디아(NVIDIA), 마이크로소프트(MS) 등 글로벌 빅테크 기업들과 하드웨어, 소프트웨어, 클라우드 인프라를 아우르는 생태계 협력을 이어가고 있다.
출처: LG그룹 유튜브 「로봇 데이터 100개 중 30개만 살아남는다? 로봇 학습이 어렵고 비싼 이유 | LG전자 박기범 담당 | 업데이트 EP.8」
0댓글
현재 댓글 작성이 비활성화되어 있습니다.