
LGエレクトロニクス、ロボット学習データを自社生成 年末までに200台規模へ
LGエレクトロニクスは、学習データの生成から精製、学習、検証までを支える「LGデータファクトリー」を運営し、ロボットの商用化を準備している。現在約100台のロボットを運用し、今年末までに200台規模へ設備を拡充する計画だ。
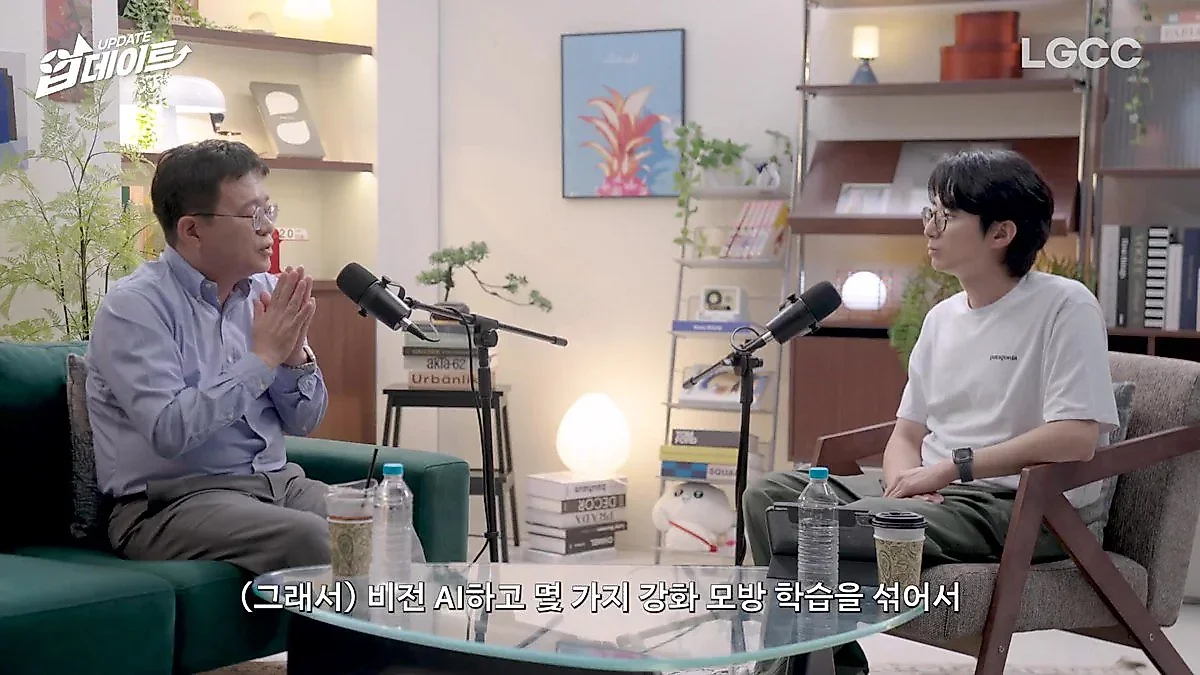
LGエレクトロニクスは、ロボットの学習データを自社で作る「LGデータファクトリー」を運営し、商用化に向けた準備を進めている。現在約100台のロボットを運用しており、今年末までに200台規模へ設備を拡充する計画だ。
ロボットが人のように動くには、膨大な学習データが欠かせない。LGデータファクトリーは、データの生成、精製、学習から検証までを支える、いわば「ロボット訓練所」の役割を担う。
人が操作して集めたデータ、学習に使えるのは約30%
LGエレクトロニクスの担当者、パク・ギボム氏によると、人がロボットを直接操作してデータを収集する「テレオペレーション(Teleoperation)」には、多くの費用と時間がかかる。熟練した作業者がロボットを操り、正解となるデータを作る必要があるためだ。それでも、収集したデータのうち実際の学習に使える量は、操作者によって差はあるものの、約30%にとどまるという。
不足するデータを補うため、仮想環境でのシミュレーションによるデータ生成や、人の動きをロボットの動きに変換する「リターゲティング(Retargeting)」、データを人為的に増やす拡張技術などが使われている。
LGエレクトロニクスは、視覚AIと模倣学習を組み合わせ、ロボットが自ら正解データを作る「オートオプス(Auto-Ops)」技術を通じ、人の介入を減らしてデータ生成を速める戦略を進めている。
現場の想定外を再学習につなげる循環
LGデータファクトリーが目指すのは、データの生成、精製、学習、検証が連続する「データ・フライホイール(Data Flywheel)」の仕組みだ。現場に投入されたロボットが想定外の環境に直面する「ドメインギャップ」が生じた際には、再びデータを集め、学習を繰り返す循環を構築する。
施設には、大規模なデータを処理するIT基盤とネットワーク環境も備えている。動画データの膨大な通信帯域に対応するため、4種類のWi-Fiを併用し、大量のGPU資源を共同利用する基盤を整えた。
パク氏は、シミュレーション段階を「模擬試験」、実際の現場での実証を「大学修学能力試験」にたとえ、段階を踏んで学習する体制を整えていると説明した。
自社機体に適したモデルを重視、One LGで協力
LGエレクトロニクスのロボット戦略は、自社の機体形態(Form-factor)に最適化したデータを直接生成し、モデルの精度を高めることに重点を置く。同社は、外部から購入したデータよりも、自社ロボットの特性を反映したデータの方が学習効率と精度で優位にあるとしている。こうした取り組みが、顧客による導入時に、少ないデータと時間でロボットに特定業務を実行させるための基盤になると位置付けている。
この戦略を支えるため、データファクトリーにはLGエレクトロニクスに加え、AI研究院、LG CNS、LGイノテックなど、グループ内の力を結集した「One LG」チームが集まっている。LGイノテックはカメラのインターフェースを担当。LG CNSは商業・物流空間へのロボット導入と顧客の要望に応じた学習支援を担い、AI研究院は独自モデルの開発を支援する。
LGエレクトロニクスは、この連携を基に、NVIDIAやMSなど世界の大手テクノロジー企業と、ハードウェア、ソフトウェア、クラウド基盤を含む事業の生態系づくりで協力を続けている。
0コメント
現在コメントの投稿は無効になっています。