
Google divide su TPU de 8ª generación: TPU 8t para entrenamiento y TPU 8i para inferencia
Google ha diseñado su octava generación de TPU dividiéndola en dos modelos específicos, el TPU 8t para entrenamiento y el TPU 8i para inferencia y aprendizaje por refuerzo, con el fin de optimizar cada carga de trabajo.
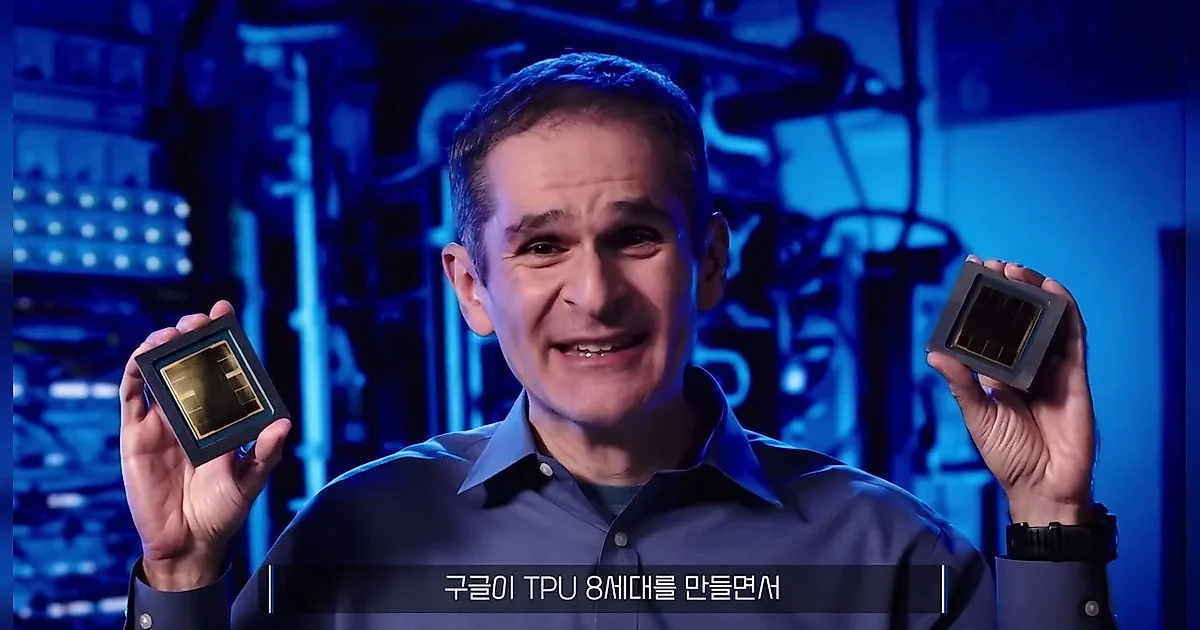
Mientras las empresas tecnológicas aceleran el desarrollo de sus propios chips de IA (xPU), el propósito del diseño de los chips se está subdividiendo según las cargas de trabajo específicas. Google ha diseñado recientemente su TPU de octava generación de forma dual, dividiéndola en el 'TPU 8t' para entrenamiento y el 'TPU 8i' para inferencia y aprendizaje por refuerzo. Esto se debe a la determinación de que los cuellos de botella que ocurren en las etapas de entrenamiento e inferencia son diferentes.
TPU 8t para entrenamiento y TPU 8i para inferencia: diferencias en el diseño de chips según la carga de trabajo
Según el video, el TPU 8t, destinado al entrenamiento a gran escala, está optimizado para procesar miles de chips agrupándolos en una sola unidad de cálculo masiva. En el proceso de entrenamiento, la clave es lograr que miles de chips continúen calculando sin descanso, más que la velocidad de respuesta de cada chip individual. Para ello, el TPU 8t incluye Sparse Core, que procesa tareas de lectura irregular de tablas de incrustación (embedding) gigantescas, y cuenta con una escala que permite conectar hasta 9,600 chips en un solo superpod.
Por otro lado, el TPU 8i, adaptado para la etapa de inferencia que genera respuestas al usuario, se centró en la eficiencia del procesamiento de datos. Durante la inferencia, es crucial el uso del caché KV que almacena información previa y el movimiento de datos en el proceso de generación de tokens. En consecuencia, el TPU 8i aumentó la capacidad de la SDRAM, la memoria rápida interna del chip, hasta 384 MB, y está equipado con el CAE, un dispositivo de comunicación que reúne rápidamente los resultados de cálculo de múltiples chips. Especialmente, utiliza el método de conexión Board Fly para reducir el tiempo de movimiento de datos en los modelos MoE (Mixture of Experts).
Límites de los chips propios, la versatilidad de la GPU y el ecosistema de software
Los chips propios tienen la ventaja de poder diseñarse conociendo con precisión los patrones de cálculo de modelos específicos. Google fabrica chips reflejando el método de cálculo de Gemini, mientras que Meta fabrica los suyos reflejando los patrones de operación de sus modelos de recomendación y publicidad. Sin embargo, dado que se requiere mucho tiempo desde el diseño del chip hasta el despliegue en el centro de datos, existe el riesgo de que los circuitos dedicados se vuelvan inútiles si aparece una nueva estructura de modelo de IA. Por el contrario, las GPU de NVIDIA poseen la versatilidad de responder rápidamente a nuevos métodos de cálculo mediante actualizaciones de software y librerías.
El ecosistema de software también es una variable importante. NVIDIA ha construido un entorno donde los desarrolladores pueden trasladar fácilmente su código existente a través de CUDA. Para complementar esto, Google opera XLA, un compilador que convierte el código del modelo en una forma de ejecución para el chip. XLA desempeña el papel de aumentar la utilidad de la TPU al mejorar la eficiencia del acceso a la memoria mediante la tecnología de fusión (Fusion), que agrupa diferentes cálculos en uno solo.
La estrategia de respuesta de NVIDIA: NVLink Fusion y NVHBM
En respuesta a la tendencia de las grandes tecnológicas hacia los chips propios, NVIDIA está adoptando una estrategia para lograr que, incluso si los clientes fabrican sus propios chips, utilicen la tecnología de conexión y memoria de NVIDIA. Una tecnología representativa es NVLink Fusion. Esta permite integrar no solo las GPU de NVIDIA, sino también los xPU o CPU fabricados directamente por los clientes en la red de conexión de NVIDIA. De hecho, Amazon (AWS) está llevando a cabo una colaboración para conectar su propio chip, Trainium, con la tecnología NVLink de NVIDIA.
Además, NVIDIA ha propuesto una forma de mejorar el rendimiento de los chips propios mediante la tecnología NVHBM. Este método consiste en trasladar las funciones de la HBM hacia el die base, ayudando a que los clientes puedan asignar más espacio a los circuitos de cálculo cuando diseñan sus propios chips. NVIDIA explicó que, con esta tecnología, se puede asegurar hasta un 25% más de área para el die de cálculo y aumentar el ancho de banda de la memoria en un 30%. Esto se interpreta como una estrategia para que, aunque el cliente fabrique directamente el chip de cálculo, mantenga la tecnología de NVIDIA para la conexión y la infraestructura de memoria que rodea al chip.
0Comentarios
Los comentarios están desactivados por ahora.