
구글 TPU 8세대 분화…학습용 8t와 추론용 8i로 용도 구분
구글의 8세대 TPU가 학습용 8t와 추론용 8i로 분화된 가운데, 빅테크의 자체 칩 전략과 엔비디아의 기술적 대응 방안을 분석한다.
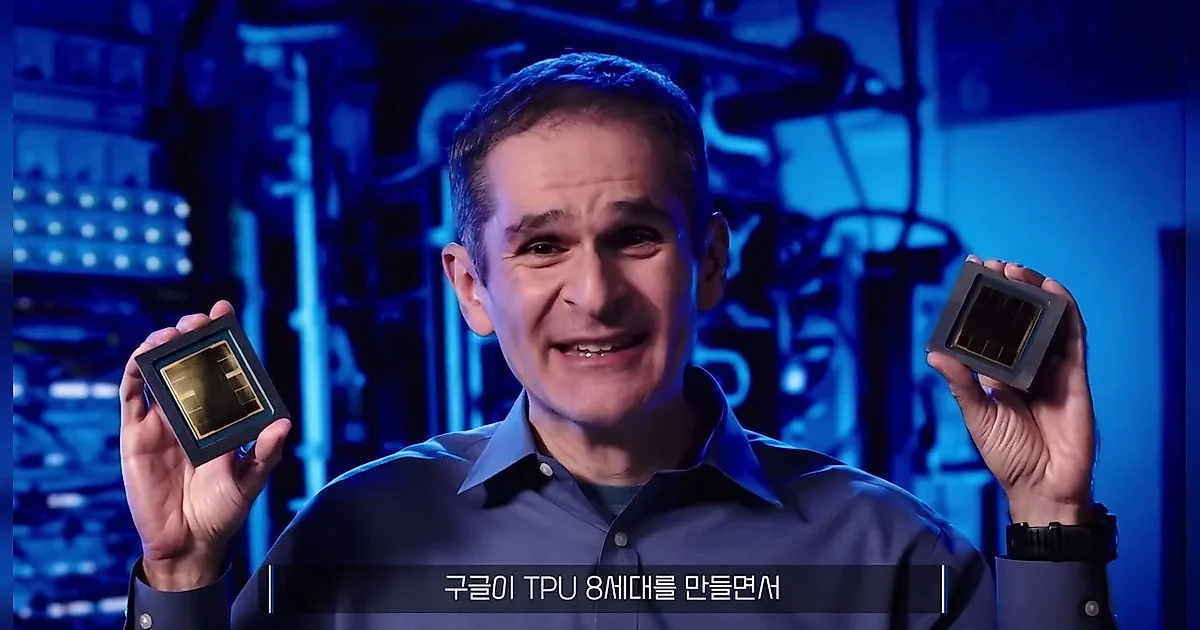
빅테크 기업들이 자체 AI 칩(xPU) 개발에 속도를 내는 가운데, 칩의 설계 목적이 구체적인 워크로드에 따라 세분화되고 있다. 구글은 최근 공개한 8세대 TPU를 학습용인 'TPU 8t'와 추론 및 강화학습용인 'TPU 8i'로 이원화하여 설계했다. 이는 학습과 추론 단계에서 발생하는 병목 현상이 서로 다르다는 판단에 따른 것이다.
학습용 8t와 추론용 8i, 워크로드에 따른 칩 설계의 차이
영상에 따르면, 대규모 학습을 목적으로 하는 TPU 8t는 수천 개의 칩을 하나의 큰 계산 단위로 묶어 처리하는 데 최적화되어 있다. 학습 과정에서는 개별 칩의 응답 속도보다 수천 개의 칩이 쉬지 않고 계산을 이어가게 만드는 것이 핵심이다. 이를 위해 TPU 8t는 거대한 인베딩 표를 불규칙하게 읽는 작업을 처리하는 스파스코어(Sparse Core)를 포함하며, 하나의 슈퍼팟에 최대 9,600개의 칩을 연결할 수 있는 규모를 갖췄다.
반면, 사용자에게 답을 생성하는 추론 단계에 맞춘 TPU 8i는 데이터 처리 효율에 집중했다. 추론 시에는 이전 정보를 저장하는 KV 캐시 활용과 토큰 생성 과정에서의 데이터 이동이 중요하다. 이에 따라 TPU 8i는 칩 내부의 빠른 메모리인 SDRAM 용량을 384MB까지 늘렸으며, 여러 칩의 계산 결과를 빠르게 모으는 통신 장치인 CAE를 탑재했다. 특히 MoE(Mixture of Experts) 모델에서 데이터 이동 시간을 줄이기 위해 보드 플라이(Board Fly) 연결 방식을 사용한다.
자체 칩의 한계와 GPU의 범용성, 그리고 소프트웨어 생태계
자체 칩은 특정 모델의 계산 패턴을 정확히 알고 설계할 수 있다는 장점이 있다. 구글은 제미나이의 계산 방식을, 메타는 자사 추천 및 광고 모델의 연산 패턴을 반영해 칩을 만든다. 하지만 칩 설계부터 데이터 센터 배치까지 긴 시간이 소요되므로, 새로운 AI 모델 구조가 등장할 경우 전용 회로가 무용지물이 될 수 있는 위험이 있다. 반면 엔비디아 GPU는 소프트웨어와 라이브러리 업데이트를 통해 새로운 계산 방식에 빠르게 대응할 수 있는 범용성을 가진다.
소프트웨어 생태계 역시 중요한 변수다. 엔비디아는 쿠다(CUDA)를 통해 개발자들이 기존 코드를 쉽게 옮길 수 있는 환경을 구축했다. 구글은 이를 보완하기 위해 모델 코드를 칩 실행 형태로 바꿔주는 컴파일러인 XLA를 운용한다. XLA는 서로 다른 계산을 하나로 묶는 퓨전(Fusion) 기술을 통해 메모리 접근 효율을 높여 TPU의 활용도를 높이는 역할을 한다.
엔비디아의 대응 전략, NVLink Fusion과 NVHBM
빅테크의 자체 칩 전환 흐름에 대응해 엔비디아는 고객사가 자체 칩을 만들더라도 엔비디아의 연결 및 메모리 기술을 사용하게 만드는 전략을 취하고 있다. 대표적인 기술이 NVLink Fusion이다. 이는 엔비디아 GPU뿐만 아니라 고객사가 직접 만든 xPU나 CPU도 엔비디아의 연결망에 통합할 수 있게 한다. 실제로 아마존(AWS)은 자체 칩인 트레인유m(Trainium)을 엔비디아의 NVLink 기술과 연결하는 협력을 진행 중이다.
또한 엔비디아는 NVHBM 기술을 통해 자체 칩의 성능을 높이는 방안도 제시했다. HBM의 기능을 베이스 다이 쪽으로 옮겨, 고객사가 자체 칩을 설계할 때 연산 회로에 더 많은 공간을 할당할 수 있도록 돕는 방식이다. 엔비디아 측은 이 기술을 통해 연산 다이 면적을 최대 25% 확보하고, 메모리 대역폭은 30% 높일 수 있다고 설명했다. 이는 고객이 연산 칩은 직접 만들더라도, 칩 주변의 연결과 메모리 인프라는 엔비디아의 기술을 유지하게 하려는 전략으로 풀이된다.
0댓글
현재 댓글 작성이 비활성화되어 있습니다.