
Googleの第8世代TPUが分化…学習用の8tと推論用の8iで用途を区別
ビッグテック企業が独自のAIチップ(xPU)開発を加速させる中、Googleは第8世代TPUを学習用「TPU 8t」と推論・強化学習用「TPU 8i」に二分化して設計しました。
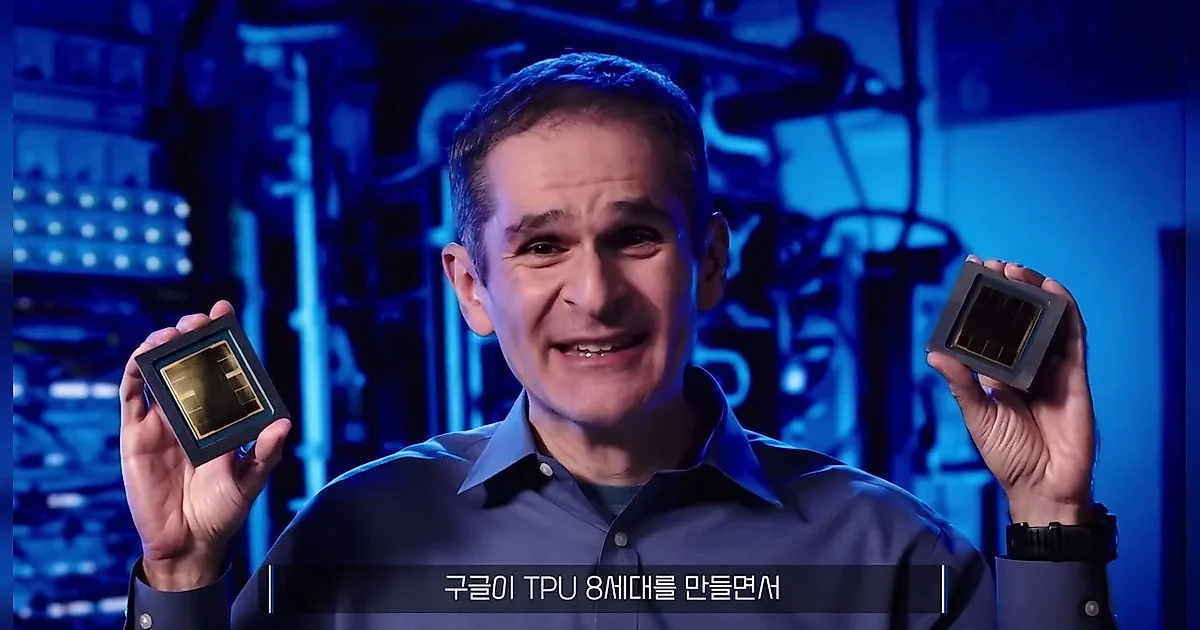
ビッグテック企業が独自のAIチップ(xPU)開発に速度を上げる中、チップの設計目的が具体的なワークロードに従って細分化されている。Googleは最近公開した第8世代TPUを、学習用の「TPU 8t」と、推論および強化学習用の「TPU 8i」に二分化して設計した。これは、学習と推論の段階で発生するボトルネックが互いに異なるという判断によるものである。
学習用の8tと推論用の8i、ワークロードによるチップ設計の違い
動画によると、大規模学習を目的とするTPU 8tは、数千個のチップを一つの大きな計算単位としてまとめて処理することに最適化されている。学習過程では、個々のチップの応答速度よりも、数千個のチップが休むことなく計算を継続させることが核心である。このため、TPU 8tは巨大なエンベディング表を不規則に読み取る作業を処理するSparse Coreを含んでおり、一つのスーパーポットに最大9,600個のチップを接続できる規模を備えている。
一方、ユーザーに答えを生成する推論段階に合わせたTPU 8iは、データ処理効率に集中した。推論時には、以前の情報を保存するKVキャッシュの活用と、トークン生成過程におけるデータ移動が重要となる。これに伴い、TPU 8iはチップ内部の高速メモリであるSDRAMの容量を384MBまで増やし、複数のチップの計算結果を素早く集める通信装置であるCAEを搭載した。特にMoE(Mixture of Experts)モデルにおいてデータ移動時間を短縮するため、ボードフライ(Board Fly)接続方式を使用する。
独自チップの限界とGPUの汎用性、そしてソフトウェアエコシステム
独自チップは、特定のモデルの計算パターンを正確に把握して設計できるという利点がある。GoogleはGeminiの計算方式を、Metaは自社の推薦および広告モデルの演算パターンを反映してチップを作る。しかし、チップ設計からデータセンターへの配置まで長い時間を要するため、新しいAIモデル構造が登場した場合、専用回路が無用になるリスクがある。一方、NVIDIAのGPUは、ソフトウェアとライブラリのアップデートを通じて新しい計算方式に迅速に対応できる汎用性を持っている。
ソフトウェアエコシステムも重要な変数である。NVIDIAはCUDAを通じて、開発者が既存のコードを容易に移転できる環境を構築した。Googleはこれを補完するために、モデルコードをチップ実行形態に変換するコンパイラであるXLAを運用している。XLAは、異なる計算を一つにまとめるフュージョン(Fusion)技術を通じてメモリアクセスの効率を高め、TPUの活用度を高める役割を果たす。
NVIDIAの対応戦略、NVLink FusionとNVHBM
ビッグテックの独自チップへの転換の流れに対応して、NVIDIAは顧客企業が独自チップを作るとしても、NVIDIAの接続およびメモリ技術を使用させるような戦略を取っている。代表的な技術がNVLink Fusionである。これはNVIDIAのGPUだけでなく、顧客企業が直接作ったxPUやCPUもNVIDIAの接続網に統合できるようにするものである。実際にAmazon(AWS)は、独自チップであるTrainiumをNVIDIAのNVLink技術と接続する協力を進めている。
また、NVIDIAはNVHBM技術を通じて独自チップの性能を高める方案も提示した。HBMの機能をベースダイ側に移し、顧客企業が独自チップを設計する際に演算回路により多くの空間を割り当てられるよう支援する方式である。NVIDIA側は、この技術を通じて演算ダイの面積を最大25%確保し、メモリ帯域幅を30%高めることができると説明した。これは、顧客が演算チップは直接作るとしても、チップ周辺の接続とメモリインフラはNVIDIAの技術を維持させようとする戦略と解釈される。
0コメント
現在コメントの投稿は無効になっています。