
Google TPU 第8代分化……区分用于训练的 8t 与用于推理的 8i
随着科技巨头加速开发自有 AI 芯片(xPU),芯片设计正根据具体工作负载进行细分。Google 最近公布的第8代 TPU 被设计为用于训练的“TPU 8t”和用于推理及强化学习的“TPU 8i”。
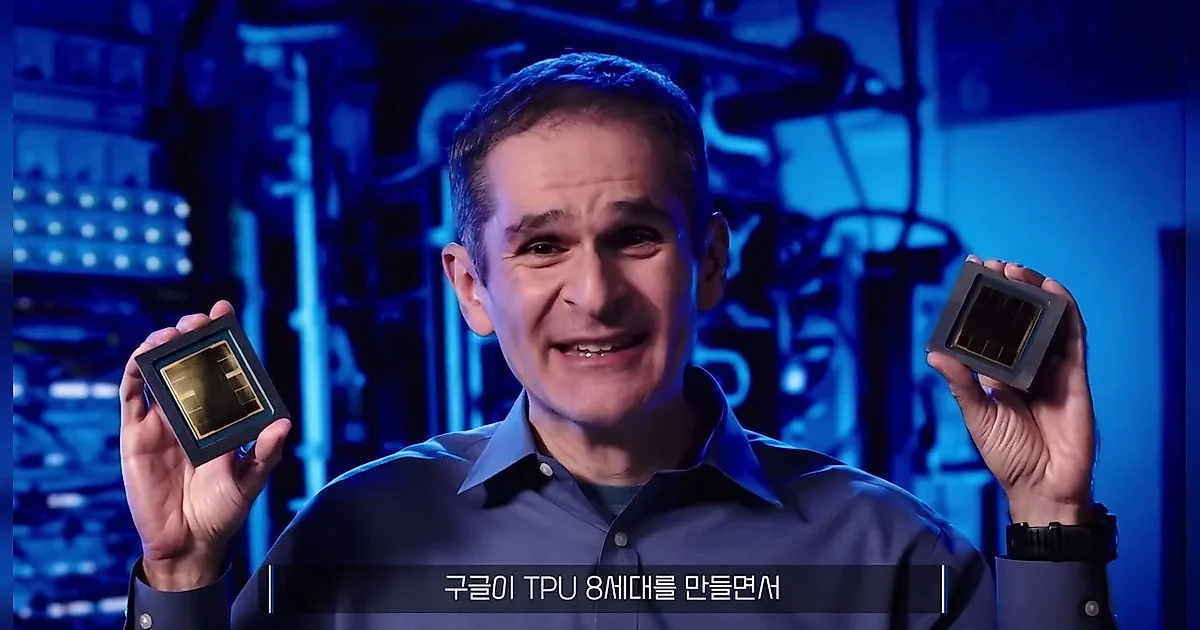
在科技巨头们加速开发自有 AI 芯片(xPU)的同时,芯片的设计目的正根据具体的工作负载进行细分。Google 最近公布的第8代 TPU 被设计为用于训练的“TPU 8t”和用于推理及强化学习的“TPU 8i”。这是基于对训练和推理阶段产生的瓶颈各不相同的判断而做出的设计。
用于训练的 8t 与用于推理的 8i,基于工作负载的芯片设计差异
根据视频显示,以大规模训练为目的的 TPU 8t 针对将数千个芯片组合成一个巨大的计算单元进行处理进行了优化。在训练过程中,核心在于如何让数千个芯片不间断地进行计算,而非单个芯片的响应速度。为此,TPU 8t 包含了处理不规则读取巨大嵌入表的 Sparse Core,并具备一个超级池最多可连接 9,600 个芯片的规模。
另一方面,针对向用户生成答案的推理阶段而设计的 TPU 8i 则专注于数据处理效率。在推理时,利用存储先前信息的 KV 缓存以及令牌生成过程中的数据移动至关重要。因此,TPU 8i 将芯片内部的快速内存 SDRAM 容量增加到了 384MB,并搭载了能够快速汇总多个芯片计算结果的通信装置 CAE。特别是为了减少 MoE(Mixture of Experts)模型中的数据移动时间,采用了 Board Fly 连接方式。
自有芯片的局限性、GPU 的通用性以及软件生态系统
自有芯片的优点在于可以准确了解特定模型的计算模式并进行设计。Google 会反映 Gemini 的计算方式,而 Meta 则会反映其自有推荐及广告模型的运算模式来制造芯片。然而,由于从芯片设计到数据中心部署需要很长时间,一旦出现新的 AI 模型结构,专用电路可能会面临变得无用的风险。相比之下,NVIDIA GPU 通过软件和库的更新,具有能够快速应对新计算方式的通用性。
软件生态系统也是一个重要的变量。NVIDIA 通过 CUDA 构建了让开发者能够轻松迁移现有代码的环境。为了弥补这一点,Google 运营着一种能将模型代码转换为芯片执行形式的编译器 XLA。XLA 通过将不同的计算合并为一体的 Fusion 技术来提高内存访问效率,从而提升 TPU 的利用率。
NVIDIA 的应对策略:NVLink Fusion 与 NVHBM
为了应对科技巨头转向自有芯片的趋势,NVIDIA 采取了一种策略,即使用户开发自有芯片,也要让他们使用 NVIDIA 的连接及内存技术。代表性技术是 NVLink Fusion。这使得不仅是 NVIDIA GPU,连客户直接制造的 xPU 或 CPU 也能整合进 NVIDIA 的连接网络中。实际上,亚马逊(AWS)正在进行将自有芯片 Trainium 与 NVIDIA 的 NVLink 技术进行连接的合作。
此外,NVIDIA 还通过 NVHBM 技术提出了提高自有芯片性能的方案。这种方式是将 HBM 的功能移至基础底座一侧,从而帮助客户在设计自有芯片时,能为运算电路分配更多的空间。NVIDIA 方面解释称,通过该技术可以确保最大 25% 的运算底座面积,并将内存带宽提高 30%。这被解读为一种策略,即使用户直接制造运算芯片,也要让芯片周边的连接和内存基础设施维持使用 NVIDIA 的技术。
0评论
当前已关闭评论功能。